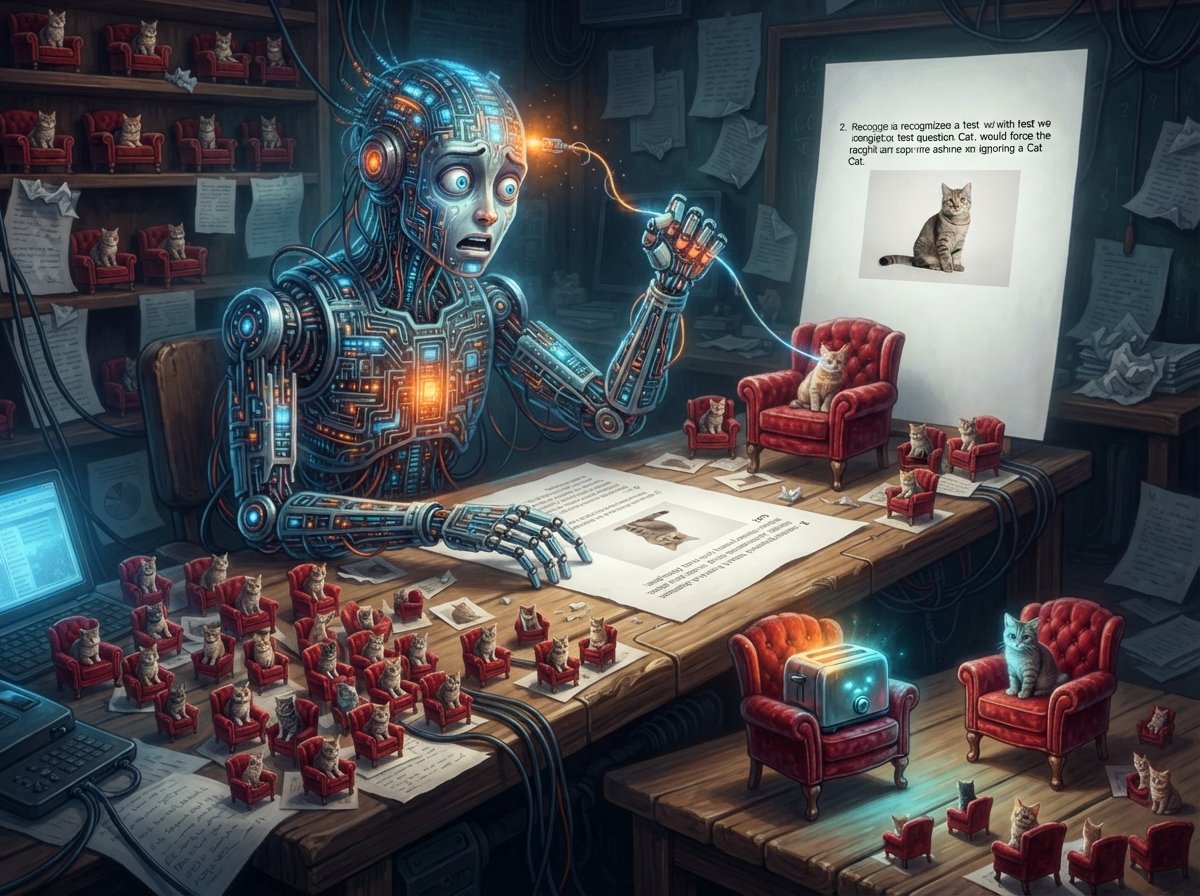
Yapay zekâ bazen dâhi bir matematikçi gibi görünür; bazen de sınavdan önce defterin kenarındaki örnekleri ezberleyip gerçek soruda donakalan panik bir öğrenciye dönüşür. İşte bu ikinci hâlin teknik adı overfitting, yani aşırı öğrenme ya da daha dürüst bir ifadeyle: öğrenmiş gibi yapma sendromudur. Model, eğitim sırasında gördüğü örnekleri o kadar ciddiye alır ki, onların ardındaki genel kuralı yakalamak yerine detaylara, istisnalara, gürültülere ve hatta kazara oluşmuş tesadüflere âşık olur.
Bir makine öğrenmesi modeli düşünelim. Ona binlerce kedi fotoğrafı gösteriyoruz. Modelin görevi kediyi tanımak. Sağlıklı bir model kulak şekli, göz yerleşimi, bıyık, beden oranı gibi genellenebilir özellikleri kavrar. Aşırı öğrenen model ise daha tuhaf bir yola sapar: Eğitim setindeki kedilerin çoğu kırmızı koltukta oturuyorsa, kırmızı koltuğu kedi olmanın gizli alameti sanabilir. Artık karşısına beyaz fonda bir kedi geldiğinde tereddüt eder; kırmızı koltukta duran bir tost makinesine ise şüpheyle miyavlayabilir.
Ezber ile kavrayış arasındaki ince bıçak
Overfitting, aslında bilgisayar biliminin çok eski bir ahlaki dersini hatırlatır: Veriye tapma, yapıyı ara. Bir modelin eğitim verisinde mükemmel sonuç vermesi tek başına iyi haber değildir. Hatta bazen kötü haberdir. Çünkü fazla mükemmellik, gerçeğe değil aynaya bakıyor olabilir. Model, geçmişin fotoğrafını piksel piksel kopyalamış; fakat geleceğin bulanık, değişken ve inatçı doğasına hazırlanmamıştır. Bu yüzden makine öğrenmesinde asıl mesele, verilen soruları doğru çözmek değil, henüz sorulmamış sorulara makul cevap verebilmektir.
Teknik olarak overfitting çoğu zaman modelin karmaşıklığı ile veri miktarı arasındaki dengesizlikten doğar. Çok güçlü, çok parametreli, çok esnek bir modeliniz varsa ve elinizdeki veri sınırlıysa, model her kıvrımı takip etmeye başlar. Bir haritacı düşünün: Dağları, nehirleri, şehirleri çizmesi gerekirken, yoldaki her çakıl taşını haritaya işlemeye kalkar. Ortaya ayrıntılı ama işe yaramaz bir harita çıkar. İyi modelleme, her şeyi bilme arzusu değil, neyi görmezden geleceğini bilme sanatıdır.
Bu yanılgıyı azaltmak için kullanılan yöntemler, makineye biraz disiplin kazandırmak gibidir. Eğitim ve test verisini ayırırız; çünkü öğrencinin çalıştığı sorularla sınav sorularının aynı olması adil değildir. Çapraz doğrulama yaparız; modelin farklı veri parçalarında nasıl davrandığını inceleriz. Düzenlileştirme uygularız; modele, aşırı karmaşık açıklamalar üretme diye hafifçe omzuna dokunuruz. Daha fazla ve daha çeşitli veri toplarız; çünkü dünya tek bir laboratuvar masasından ibaret değildir. Bazen de modeli küçültürüz. Evet, yapay zekâda da kas yapmak kadar sadeleşmek önemlidir.
Overfittingin eğlenceli tarafı, onun yalnızca makinelerin hatası olmamasıdır. İnsan zihni de benzer tuzaklara düşer. Bir kez kötü bir sunum izleyip tüm konferansları sıkıcı sanmak, iki yatırım örneği görüp piyasayı çözdüğünü düşünmek, çocuklukta yaşanan bir olayı tüm ilişkilere şablon yapmak… Bunlar da zihinsel overfittingdir. Beyin, az veriden büyük kanunlar çıkarmaya bayılır. Yapay zekâ bize yalnızca algoritmaların değil, kendi aklımızın da nasıl yanlış genellediğini gösteren parlak bir ayna tutar.
Bu yüzden overfitting yalnızca teknik bir problem değil, bilginin doğasına dair bir uyarıdır. Gerçek öğrenme, geçmişi ezberlemekle başlamaz; geçmişin içinden geleceğe taşınabilecek deseni ayıklamakla başlar. İyi model, gördüğünü papağan gibi tekrarlayan değil, görmediği karşısında da dengede kalabilendir. Kısacası yapay zekâya öğretmemiz gereken şey sadece cevaplar değildir. Ona, her cevabın ardında değişmeyen bir ilke olup olmadığını sormayı öğretmeliyiz. Çünkü zekâ, verinin kalabalığında kaybolmadan kuralın sessiz omurgasını bulma cesaretidir.